One-Way- und Two-Way-Avatare: Warum Video-Avatare kein Rollenspiel sind
Nach meinem Beitrag über die drei Stufen des KI-Rollenspiels hatten die meisten die Botschaft verstanden: Dialogfähige Avatare haben nichts mit Copilot zu tun, und sie sind auch kein Chatbot mit einem statischen Gesicht.
Die Folgefrage lautet oft: „Dann ist das also so ähnlich wie Video-Avatar-Tools?“ Eine naheliegende Vermutung, aber nein. Das sind zwei unterschiedliche Technologien, entwickelt für zwei völlig unterschiedliche Zwecke.
One-Way-Avatare vermitteln Inhalte
Bei Video-Avatar-Tools schreiben Sie ein Skript, das in Sprache umgewandelt, lippensynchron auf ein Gesicht gelegt und als Video exportiert wird. Sobald es gerendert ist, ist es fertig: dasselbe Video, jedes Mal, für alle Zuschauenden. Der Zweck ist die Vermittlung von Inhalten, etwa Onboarding-Videos, Ankündigungen und Produkterklärungen. Sie schauen es sich an, und das ist die gesamte Interaktion.
Mit Two-Way-Avataren können Sie üben
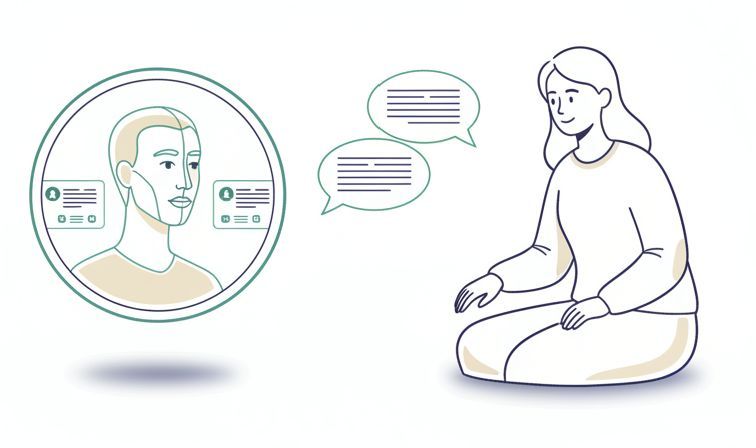
Die andere Art nenne ich Two-Way-Avatar, weil das Sprechen in beide Richtungen geht. Das ist es, was wir entwickeln. Es ist ein ungeskriptetes Gespräch in Echtzeit: Sie sprechen, der Avatar hört zu und antwortet live, basierend auf dem, was Sie tatsächlich gesagt haben. Er merkt sich das Gespräch, bleibt in seiner Rolle (ein schwieriger Kunde, eine nervöse neue Führungskraft, eine Kandidatin im Vorstellungsgespräch) und reagiert in Echtzeit auf Sie.
Der Zweck ist hier das Üben: ein echtes Gespräch proben, bevor es stattfindet, und Soft Skills aufbauen.
Warum der Unterschied wichtig ist
Das eine vermittelt Informationen. Mit dem anderen können Sie in einem geschützten Raum üben, Fehler machen, nachjustieren und es erneut versuchen, und genau das bewirkt Verhaltensänderung. Ein Video wird das nie leisten, egal wie oft Sie es ansehen.